[!NOTE]
【この記事の要約(TL;DR)】
- 問題の所在: 気になったWeb記事を手動コピペや通常のブラウザ拡張機能でObsidianへ溜め込むと、「検索ノイズの激増」「Vaultの肥大化」「AI読込時の精度低下・トークン浪費」という3大リスクに直面しやすい。
- 解決策: 「毎朝の要約(Slack通知)でふるいにかけ、手元に残す価値のある記事だけを機械的+AIクレンジングで全文保存する」二段構えのパイプラインを構築する。
- 運用の要: 外部の参考資料・競合リサーチ記事が「自作ブログの下書き」と混同しないよう、専用ディレクトリへの隔離(
30_Resources/Web_Clips/)と接頭辞([Clip]_)、およびデータ経路を考慮した安全設計を施す。
1. Web記事をそのままObsidianに溜め込む「3大リスク」
気になった技術記事や一次情報をObsidianにストックし、個人ナレッジベース(PKM)として活用する手法は広く普及しています。しかし、「URLをただ保存する」あるいは「ページのHTML/Markdownをそのまま流し込む」という運用を続けると、長期的には以下の3つの問題が起こりやすくなります。
① 検索汚染(Search Noise Pollution)
Webページには、本文以外に広告、ナビゲーションメニュー、関連記事リンク、フッター、利用規約などの膨大なノイズが含まれています。これをそのままVault内に保存すると、後からObsidianでキーワード検索をかけた際、「広告テキスト」や「サイドバーのリンク」が検索結果に大量にヒットし、本来探したかった自分のメモや重要な知見に辿り着けなくなります。
② AI連携時の精度低下とトークン浪費
Obsidian内のノートをGemini、NotebookLM、あるいはローカルLLMにコンテキストとして渡す運用を行う際、ノイズだらけの長文は好ましくない影響をもたらします。
- トークン枠の浪費: 広告やヘッダー等の不要な文字列でコンテキストウィンドウを消費する。
- 回答品質の低下や誤認の誘発: 余計なテキストがコンテキストに混入することで、AIが参照すべき主要情報を見失い、回答の精度や一貫性に悪影響を及ぼす要因になり得ます。
③ 蓄積疲れによる死蔵(デジタルゴミ屋敷化)
手動でコピー&ペーストし、整形する作業は継続負荷が高すぎます。一方でワンクリックで丸ごと取り込むクリッパーを無秩序に使うと、数週間で「読まない生データ」が数十件溜まり、整理不能に陥ってVault自体を開くのが億劫になります。
2. 「要約の保存」と「全文の保存」の決定的な違い
情報収集において、「要約だけで済ませる」のと「全文を保持する」のとでは、果たすべき役割が根本から異なります。
| 項目 | 要約(Summary / Briefing) | 全文保存(Cleaned Full-Text) |
|---|---|---|
| 主な用途 | 毎朝の速報チェック、意思決定 | 技術的検証、コード引用、自作記事の論理展開を支える根拠資料 |
| 役割 | 「今読むべきか」を決めるフィルター | 後から何度でも参照できる「長期保存資料」 |
| 情報密度 | 60〜150文字程度(論点のみ) | 数千〜数万文字(手順、図表、コード、論理展開) |
| AIとの相性 | 全体像の把握・分類に最適 | 詳細な分析・独自見解の生成・壁打ちに必須 |
すべてを最初から全文保存する必要はありません。「毎朝の要約で全体を俯瞰し、本当に手元に残す価値があると判断した記事のみを、ノイズを大幅に削ぎ落として全文保存する」 という二段構えのフローが、時間とリソースの浪費を最小限に抑えます。
3. crawl4ai × Gemini 3.1 Flash-Lite によるクリーン抽出の仕組み
Webページのノイズを削ぎ落としてMarkdown化する技術として注目されているのが、LLM向けオープンソースクローラー「crawl4ai」と、軽量AIモデルによる二段構えの抽出パイプラインです。
なぜ crawl4ai なのか?
crawl4aiは単なるスクレイピングライブラリではありません。
- JavaScript描画(SPA)へのネイティブ対応: ReactやNext.js等で動的にレンダリングされる最新の技術ドキュメントも正確に取得可能。
- 柔軟なコンテンツフィルタリング: PruningContentFilterやBM25アルゴリズムを活用し、HTMLのヘッダー・フッター・ナビゲーション・広告枠をAIを使わずに機械的に大幅除去したクリーンなMarkdown(
fit_markdown)を高速生成できます。
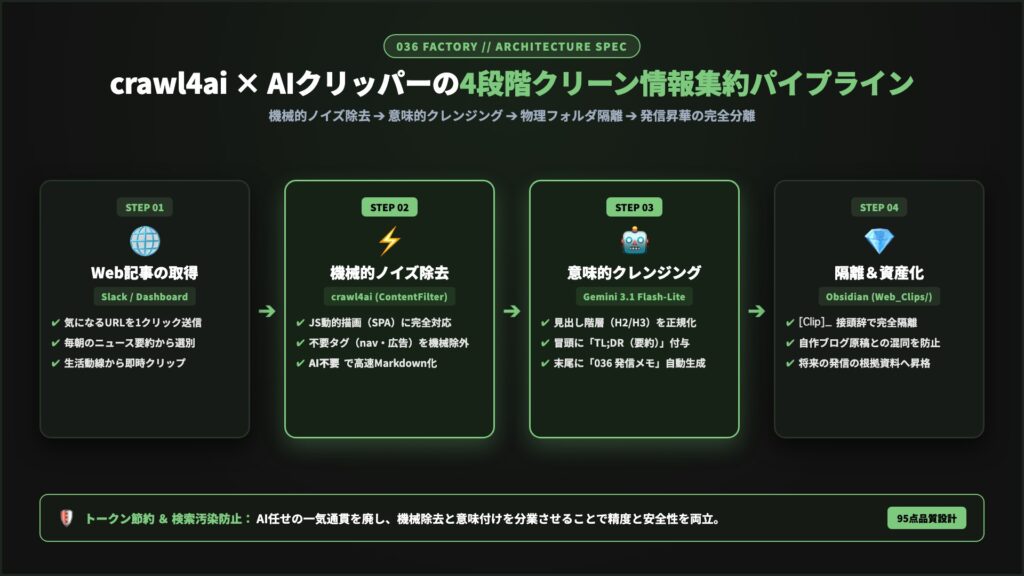
機械的なフィルタリングを先行させ、意味的な整形やメタデータ付与のみをGemini 3.1 Flash-Liteに任せることで、APIトークン消費とレイテンシを抑えながら、純度の高いマークダウン資産へ変換できます。
4. 自作ブログや競合リサーチと混同させない「安全設計」
外部の優れたWeb記事や競合サイトの分析記事を取り込む際、最も注意すべきなのは「自分が執筆しているブログの下書きと混同してしまうこと」です。
WordPress連携ツールやブログ投稿アシスタントを使用している場合、外部記事が誤って下書き一覧に混ざると、誤投稿や著作権トラブルに直結します。これを防ぐため、以下の3つの防壁(セーフガード)を講じます。
① ディレクトリの完全分離
自作原稿と外部資料の置き場所をシステムレベルで明確に分離します。
- 自作ブログ原稿(Output):
Obsidian_Notes/10_Projects/01_Blog_Drafts/およびarticles/ - 外部Webクリップ(Resource):
Obsidian_Notes/30_Resources/Web_Clips/
② ファイル名プレフィックスとFrontmatter識別子
ファイル名の一覧を見ただけで外部資料だと判別できるようにし、投稿ツールの自動検知からも除外します。
- ファイル名:
YYYYMMDD_[Clip]_記事タイトル.md - Frontmatter:
type: "web_clip"を必須化し、ブログ投稿アシスタント(type: "blog_draft"を対象)が下書きとして読み込まないようフィルタリング。
③ 先頭識別コールアウトの義務化
Obsidianでノートを開いた瞬間、外部資料であることが視覚的にわかるよう、ノートの先頭に必ずコールアウト枠を配置します。
> [!INFO] 🌐 外部Web記事・競合リサーチ資料(参照・インプット用)
> - 元記事URL: https://example.com/article
> - 取得日時: 2026-09-05 07:25
> - 位置づけ: 036 Factory 外部ナレッジ(※自作ブログ原稿ではありません)
【補足】データ経路と情報管理の安全性(Security & Privacy)
WebからAIを経由してローカルVaultへ取り込むデータフローにおいて、以下の安全基準を徹底しています:
- ローカル保存とAPI外部送信の峻別: 蓄積されたファイルはすべてローカルのMarkdownファイルとして安全に管理されますが、整形時にAIモデルへ送信されるデータ経路を把握し、外部クラウドへ無防備に情報が漏洩しないよう管理します。
- 個人情報・ログイン壁の保護: 会員限定ページや個人情報が含まれうるURLは自動巡回の対象外とし、手動確認の上でのみ取り扱う運用を徹底します。
5. 外部記事を自分たちの発信へ昇格させる「メモ欄」の自動付与
競合サイトや技術記事を保存する目的は、単なる保管ではなく「自分たちの発信(ブログ・SNS・開発)のネタや論理展開の根拠資料として活用すること」にあります。
そこで、クリップ保存時にAIが記事の最末尾へ以下の「036 Factory 展開の切り口」を自動付与する仕組みを導入します。
---
## 💡 036 Factory 記事・発信の切り口(Annのメモ)
- 旦那様の一次情報・スタンスと重ねるポイント:
  (例:記事で語られている自動化の難しさと、自分が実務で体験したエラーの共通点)
- 036 Factory視点での差別化・反論の軸:
  (例:大企業向けの重厚な運用に対し、個人開発者ならではの泥臭い安全設計を提示する)
- ブログ・SNS化する際の仮タイトル案:
(例:「無人エージェントを動かす前に決めるべき、たった1つの停止ルール」)後からブログを書く際は、このクリップを参照元([[YYYYMMDD_[Clip]_記事名]])として引用・着想を得つつ、01_Blog_Drafts/ に自分自身の言葉と一次体験を綴った新規下書きを作成します。
[!CAUTION]
著作権および適切な引用に関する重要事項
外部Web記事を個人のObsidian Vaultに保存して学習・研究に役立てることと、その文章を公開することは全く別問題です。保存した全文をそのまま自身のブログやSNSに転載してはなりません。外部の知見を取り入れる際は、必ず要約・自身の考察を交え、元記事への適切なリンク・出典明記(引用要件の遵守)を行ってください。
6. 実装の要点:生活動線に溶け込ませる
高度な抽出スクリプトを作っても、「ターミナルを開いてコマンドを叩く」運用では長続きしません。日常の動作の中で無意識に使える導線設計が不可欠です。
- Slack連携: 気になる記事のURLをSlackに貼る、または「保存 」と送信するだけで、裏でスクリプトが走りObsidianに格納される。
- ダッシュボード連携: 毎朝のニュース一覧画面から「📥 Obsidianに保存」ボタンを押すだけでバックグラウンド保存され、完了後は「📖 Obsidianで読む」ボタンから1発で該当ファイルへジャンプできる。
「思いついた瞬間に1アクションで済む仕組み」を用意して初めて、ナレッジの自動蓄積は実務に定着します。
7. まとめ
- 生データの無秩序な蓄積はVaultを汚染する: 広告やノイズを大幅に削ぎ落とすクレンジングが不可欠。
- 要約と全文を使い分ける: 要約で広く浅くフィルタリングし、厳選した記事のみを高品質に全文保存する。
- 混同を防ぐ境界線を引く: 外部クリップは
30_Resources/Web_Clips/に隔離し、[Clip]_接頭辞とメタデータで自作原稿と明確に区別する。 - 発信の切り口を添えて保存する: 単なるスクラップで終わらせず、自社・自身のスタンスと接続するメモを残すことで、初めて知識が「生きた武器」になる。
ツールを単体で導入するのではなく、「フィルタリング」「ノイズ除去」「安全な保管場所」「発信への接続」を一連のパイプラインとして設計することこそが、ナレッジ管理の真のレバレッジとなります。