「最初は的確に答えてくれていたAIが、対話が長くなるにつれて前提を取りこぼし、見当違いな回答を出し始める」
実務や開発、コンテンツ制作などで日常的に大規模言語モデル(LLM)を活用している方なら、誰もが一度は経験している現象ではないでしょうか。
多くの現場では、こうした回答精度の低下が起きると「プロンプトの指示が曖昧だったのではないか」「『過去の指示は無視して』と一言添えれば直るのではないか」と、プロンプトの微修正(足し算)で解決しようとしがちです。
しかし、2026年にMicrosoft Researchの研究チームが発表した論文『LLMs Get Lost in Evolving User Intent』は、この問題を考える上で重要な知見を示しています。
研究では、単発の課題では高い性能を示すLLMであっても、対話の途中でユーザーの意図が追加・修正・転換されると、性能が大幅に低下する傾向が確認されました。
これは、単発のベンチマークだけでは、実務における長期的な対話への追従能力を十分に評価できないことを意味します。問題をプロンプトの巧拙だけに帰着させず、タスクの分割やコンテキストの管理を含めたシステム設計の観点から考える必要があります。
1. 静的評価で高性能なAIが「動的な対話」で性能を落とす理由
一般的なベンチマークで高い性能を示すモデルであっても、長期的な対話業務で同様の安定感を発揮できるとは限りません。その背景には、評価環境と実務環境における決定的な違いがあります。
人間の意図は対話の過程で「動的に変化」する
現実の業務において、人間が最初の1プロンプトですべての制約や要件を完璧に提示することは稀です。通常は以下のように、対話の進展に伴って意図が段階的に変化・更新されます。
- 条件の段階的追加: 「あ、そういえば予算は〇〇円以内で」「文字数は800字程度にして」
- 方針の修正: 「やっぱりA案ではなくB案のアプローチに切り替えて」
- タスクの割り込み: 「その前に、関連するこのデータだけ先に集計して」
Microsoftの研究チーム(Jihoon Tack、Philippe Laban、Jennifer Nevilleら)は、GSM8K、BIRD-SQL、BrowseComp+、SWE-Bench Verifiedの4領域を対象に、人間が途中で要件を追加・修正・転換する「動的設定(Evolving Intent)」へ変換し、主要モデル群の追従能力を検証しました。
その結果、静的な単発テストで極めて高い正答率を誇るモデルであっても、対話の途中でユーザーの意図が変化すると、同一のタスクであるにもかかわらず大幅な性能低下を示すという一貫した傾向が確認されました。
モデルは最初の指示に強く引っ張られるか、あるいは後から追加された微細な制約を見落とし、過去の前提と現在の指示の優先順位を正しく統合できなくなる傾向があります。
2. 「Context Rot」と「Evolving Intent」の混同を避ける
「前の会話内容は一旦無視して、次の指示に従ってください」
このようにプロンプトで過去のログを打ち消そうとしても、期待通りの効果は得られにくいのが実情です。ここで理解しておくべきなのは、対話の長期化に伴う問題には「コンテキストの長さそのものに起因する問題」と「意図の動的変化に起因する問題」の2つの側面があるという点です。
| 概念 | 主な課題 | 現場で現れる具体的な症状 |
|---|---|---|
| Context Rot(文脈の肥大化・劣化) | 長いコンテキストで必要な情報の利用性能が低下する現象 | 過去のエラーログや長大な参考資料に注意が分散し、プロンプト内の重要な制約を見失う |
| Evolving Intent(意図の動的変化) | 対話の途中で変化・更新されるユーザーの目的や条件を追跡する難しさ | 初期の前提に引きずられ、後から追加された「〇〇は除外して」などの修正指示を取りこぼす |
長い対話で重要な指示を見失う理由
長い対話では、過去の情報が大量に残ることに加え、古い条件と新しい条件の区別、変更された要件の追跡、必要な情報の検索などが難しくなります。
TransformerモデルにおけるAttention(注意機構)は、入力されたトークン間の関連性を動的に計算しますが、モデルや入力文脈によって重要な情報への注意の向け方は変化します。古い試行錯誤やエラーログ、取り下げられた過去案がコンテキスト内に大量に残っていると、後から与えられた指示への適切な焦点化が妨げられやすくなります。
これは単純に「呪文のような言い回し」を工夫するだけで根本解決できるものではなく、作業環境そのものをクリーンに保つアプローチが求められます。
3. 実務的な設計原則:プロンプトをこねるな、「境界」を引け
※注意: ここから紹介する設計原則は、同論文が直接検証した解決策ではありません。研究が示す課題を踏まえ、現場での実務リスクを抑えるために採用できるシステム設計上のアプローチです。
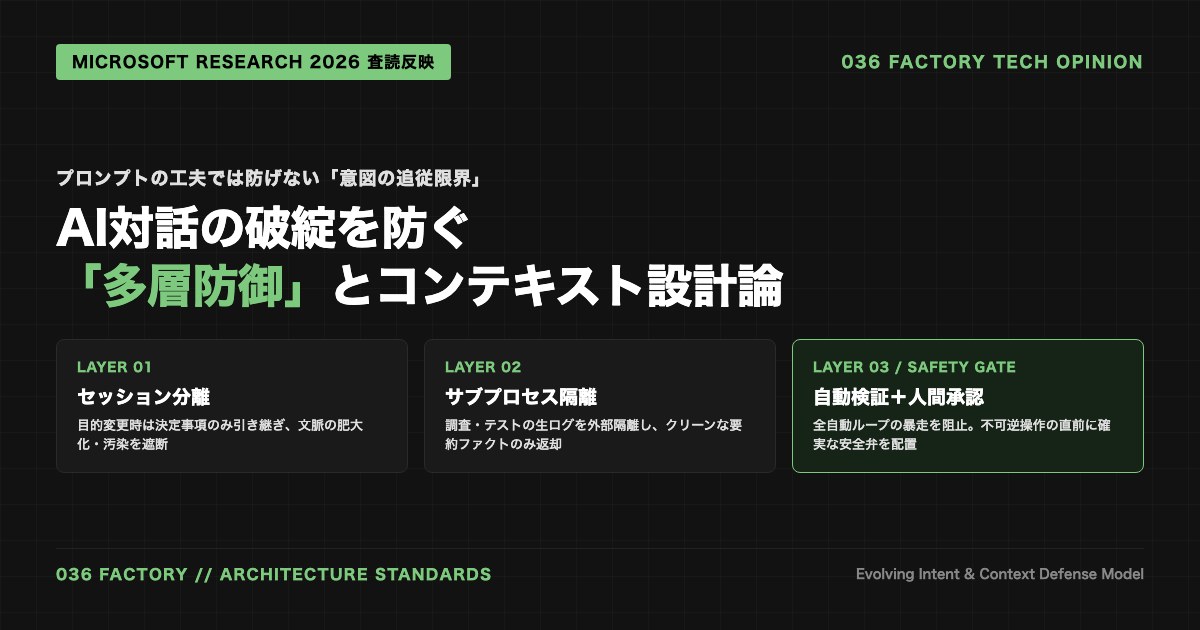
対話の長期化による精度のブレを抑えるための正攻法は、プロンプトの足し算に頼るのではなく、「セッション、役割、実行環境の境界を明確に分離すること」です。
現場で有効に機能する設計原則は、以下の3点に集約されます。
| 設計原則 | 従来のやり方(リスク高) | 推奨される設計(堅牢) |
|---|---|---|
| ① 1タスク・1セッション | 1つのチャット画面で調査・設計・執筆・デバッグを延々と続ける | 重要な条件変更時や混乱が生じた際、決定事項を引き継ぎセッションを切り替える |
| ② サブプロセスへの隔離 | メインAI自身にWebブラウジングや長大な生ログの解析を行わせる | 大量の中間データを生む作業は独立した別エージェントや外部スクリプトに投げる |
| ③ 軽量コンテキストの受け渡し | 過去の会話履歴をすべて引き継ぐ | 決定事項と前提条件だけを抽出した「要約ファクト」のみを渡す |
実践例:役割分離によるマルチエージェント構造
たとえば高度なエージェントシステム(Claude CodeやAntigravity等)では、環境に応じて以下のように役割を切り離して運用します。
- メインエージェント(司令塔): 全体の設計、方針決定、成果物の統合を担当。会話履歴を常に最小限・クリーンに保つ。
- サブエージェント/外部スクリプト(手足): ディレクトリの全探索、ドキュメントの網羅的リサーチ、単体テストの実行などを担当。終了後は「要約ファクト」のみをメインに返却する。
中間処理のログをメインエージェントから分離し、決定事項や必要な根拠だけを渡すことで、コンテキストの肥大化を抑えやすくなります。
ただし、要約による情報の欠落や、エージェント間の認識のズレという新たな失敗要因も生じるため、重要な条件は明示的に引き継ぎ、成果物を機械的・客観的に検証する仕組みが不可欠です。
4. 【最大の盲点】全自動エージェントの危険性と「多層防御」の設計
ここで、実務者が最も警戒しなければならない点があります。それは「エージェント同士を裏で完全に直結させた全自動ループの危険性」です。
世間では「完全自律型AIが寝ている間にすべての業務を片付けてくれる」といったシナリオが語られがちですが、安全機構を持たない全自動化は、実務において極めて高いリスクを孕んでいます。
一度狂うと止まらない「ハルシネーションの連鎖」
AIが前提を1箇所でも誤認した瞬間、外部からのブレーキがない全自動システムでは以下のドミノ倒しが発生しやすくなります。
- 自己正当化の連鎖: 誤った前提をもとに、AIがもっともらしい理由を次々と捏造する。
- 誤情報の伝言ゲーム: 親AIの誤認を、子AI(サブエージェント)が疑わずにブラウザ操作やファイル操作へ適用する。
- 不可逆な実被害: 大切な本番データの上書き削除、誤った設定のデプロイ、SNSへの誤爆投稿などが検知されないまま実行される。
AIが間違った方向に転がり始めたとき、外部から強制停止できる仕組みがなければ、全自動化は単なる「高速な事故発生装置」になりかねません。
人間の承認ゲートを過信しない「多層防御」の構築
では、人間が確認すれば万全かというと、それも過信です。人間側にも疲労や見落としが存在するため、「機械的な制限」と「人間の関所(ゲート)」を組み合わせた多層防御を構築する必要があります。
推奨される実務パイプラインは以下の通りです。
- 第1層:AIによる下準備:
Gemini等のLLMがリサーチ、草案作成、コード変更案の生成を全力で行う。 - 第2層:機械的な自動検証:
テスト実行、フォーマットチェック、操作対象ディレクトリや権限の機械的な制限(サンドボックス)。 - 第3層:人間の承認ゲート(安全弁):
公開、送信、削除、本番反映など、影響が大きい不可逆な操作の直前で、人間が結果を確認して「承認」ボタンを押す。 - 第4層:実行後の検証と復旧性:
実行結果の監査ログ保存、バージョン管理(Git等)によるロールバック手段の確保。
自動検証、人間の承認ゲート、ロールバック手段を組み合わせることで、AIの誤認が実害に直結するリスクを抑えられます。重要なのは、AIを完全に信頼することではなく、「誤りが発生しても検知・停止・復旧できる境界線をシステム側に設けておくこと」です。
5. まとめ:AI活用の勝敗は「コンテキスト管理」と「多層防御」で決まる
Microsoftの論文が提示した知見は、「より巧妙なプロンプトを探す時代」から、「いかにAIの作業環境(コンテキスト)を清潔に保ち、破綻リスクを抑える安全機構を設計するかというアーキテクチャの時代」への移行を物語っています。
- AIの回答精度が落ちてきたら、プロンプトを疑う前にセッションの肥大化や意図の変化を疑う
- 重要な条件変更や混乱が生じた場合は、決定事項を引き継いでセッションを切り替える
- 中間処理や調査タスクはサブプロセスに隔離し、決定事項のみを本流に渡す
- 全自動ループを過信せず、自動検証・人間の承認ゲート・ロールバック性を備えた多層防御を敷く
どれほど高性能な知能であっても、安全機構のない環境では事故を防ぎきれません。AIの自律性に過度な期待を寄せるのではなく、誤りを検知・停止・復旧できる仕組みをあらかじめ備えておくことこそが、実務でAIを使い続けるための絶対条件といえます。
参考資料・一次情報リンク
- Microsoft Research:論文紹介ページ
- arXiv:論文本文・アブストラクト(arXiv:2607.20734)
- GitHub:Microsoft Research 評価フレームワーク公開リポジトリ
☕ 思考を研ぎ澄ます合間に「普通のコーヒー」を焼いています
036 Factoryの本業は、ご注文をいただいてから生豆を一粒ずつ手作業で選別(ハンドピック)して焙煎する、小さな自家焙煎珈琲工房です。
AIの実装やプログラミング、執筆で加熱した頭をふっとリセットする、雑味のない「毎日飲める普通のコーヒー」を少量ずつ丁寧に焼いています。作業や思考の合間のひと休みに、ぜひ一度うちの工房を覗いてみてください。
☕ 思考を研ぎ澄ます合間に「普通のコーヒー」を焼いています
036 Factoryの本業は、ご注文をいただいてから生豆を一粒ずつ手作業で選別(ハンドピック)して焙煎する、小さな自家焙煎珈琲工房です。
AIの実装やプログラミング、執筆で加熱した頭をふっとリセットする、雑味のない「毎日飲める普通のコーヒー」を少量ずつ丁寧に焼いています。作業や思考の合間のひと休みに、ぜひ一度うちの工房を覗いてみてください。