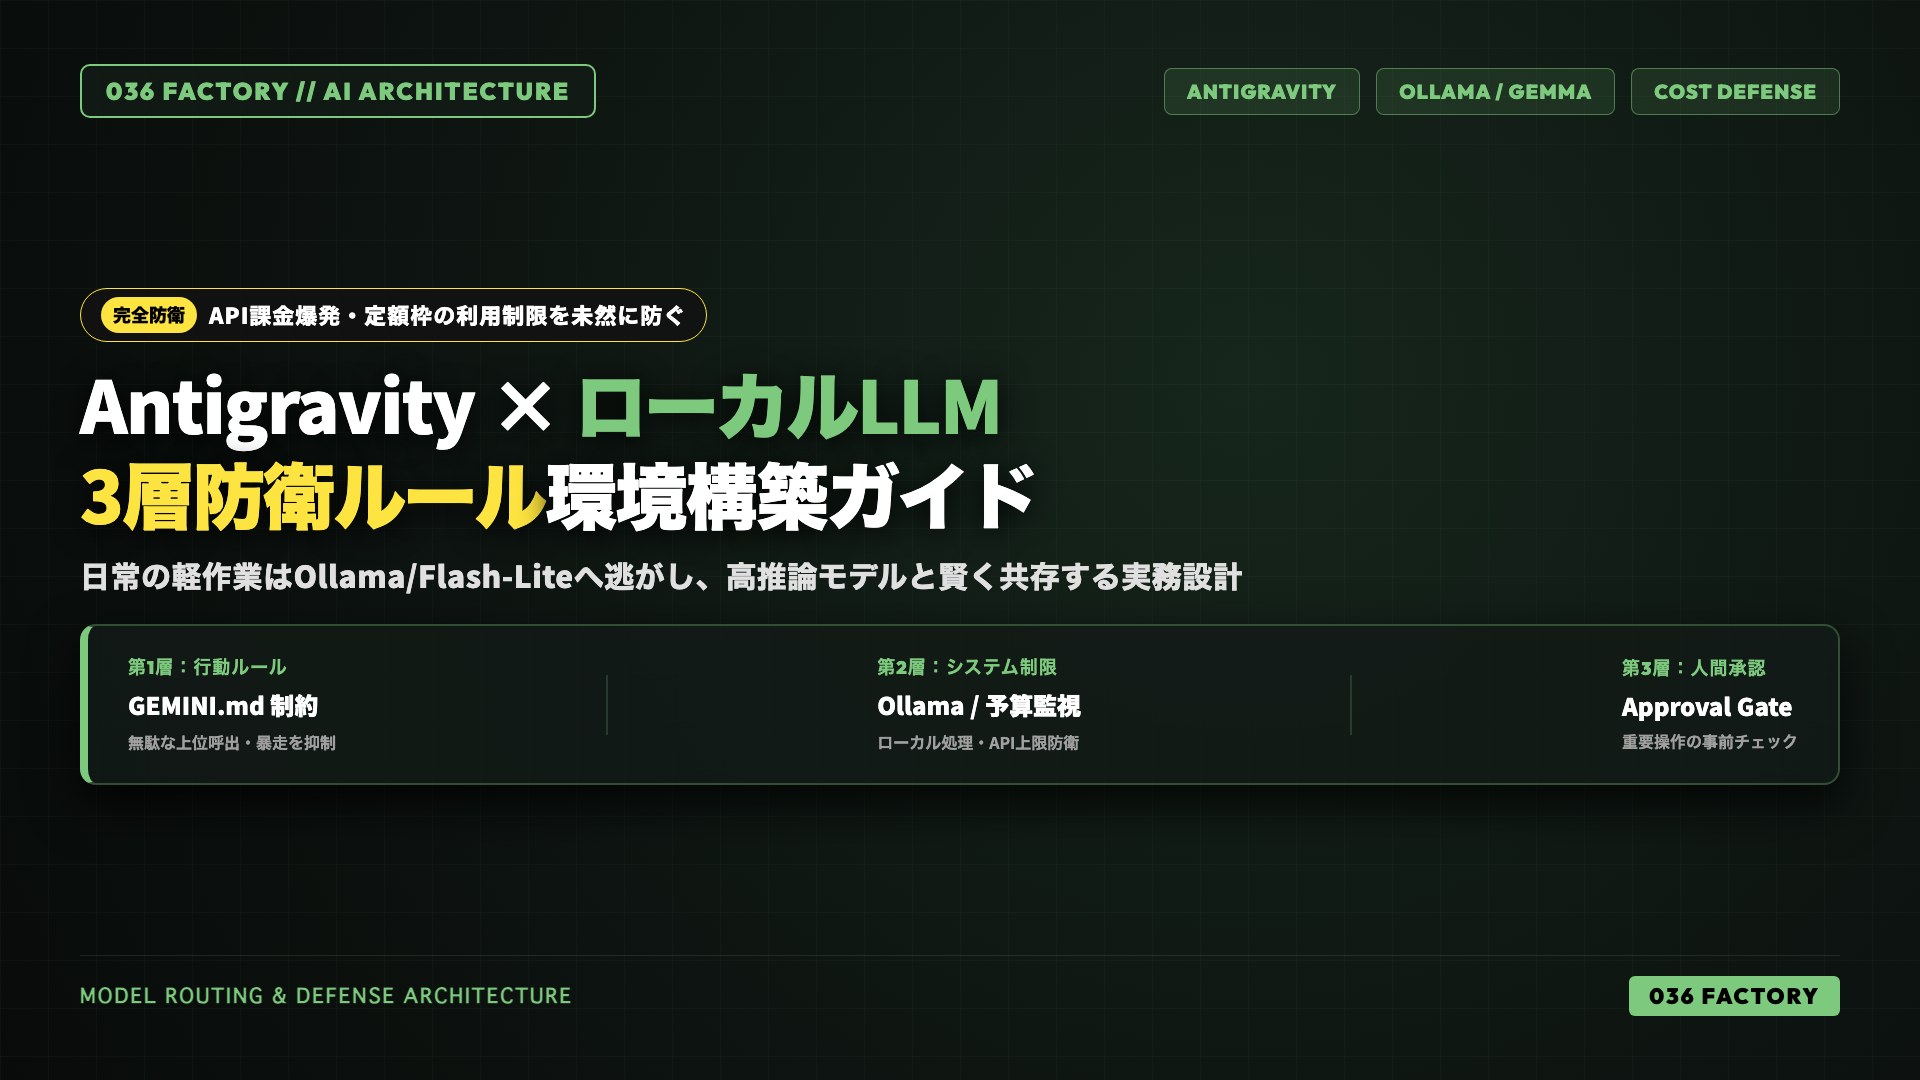
- 課題: AntigravityやCursor等の自律型AIエージェントを実務で運用すると、意図しない上位モデル呼び出しや無限ループにより「従量課金の高額請求」や「サブスク利用制限による作業中断」のリスクが高まりやすい。
- 解決策: 高性能な推論モデルと軽量処理(ローカルLLM / Flash-Lite / クラウド無料枠)を使い分けるとともに、「行動ルール・システム制限・人間承認」の3層防衛アーキテクチャを導入する。
- 実践: 読者の環境に合わせた「4つの運用ルート」の選び方、Antigravity SDK(`LocalOpenAIAgentConfig`)によるローカルLLM連携の公式実装例、コピペで使える「GEMINI.md暴走抑止ルール」を公開。
1. なぜいま「AIエージェントの多層防衛」が必要なのか?
AntigravityやCursor、Claude Codeなどの自律型AIエージェントを導入すると、開発やリサーチ、ドキュメント執筆のスピードは劇的に向上します。
しかし、エージェントを日常的に稼働させるようになると、多くのユーザーが「2つの現実的な運用リスク」に直面します。
- 従量課金APIの予期せぬコスト増(トークン消費の累積): エージェントが自律的に多数のファイルを走査したり、エラー修正の試行錯誤ループを繰り返すことで、気づかないうちにAPI利用料が膨らむリスク。
- 定額サブスク・上位モデルの「利用制限(クォータ上限)」による作業中断: Google One AIプレミアム等の定額枠や各サービスの無料枠であっても、上位の推論特化モデルを多用し続けると週間レートリミットに達し、一時的に利用制限がかかるリスク。
【リスクが高まりやすい運用】
全タスク(ファイル検索・軽微な修正・要約) ➔ すべて高価なProモデルに丸投げ ➔ コスト増&制限枯渇のリスク

【本記事で推奨する多層防衛アーキテクチャ】
日常の軽作業・走査・修正(大部分) ➔ ローカルLLM / Flash-Lite / クラウド軽量枠(低コスト・低負荷)
高度な設計・複雑な推論(核心部) ➔ Pro / 高推論モデル(ピンポイント投入)
日常作業における「ファイルの読み込み」「コードの微修正」「要約」「フォーマット整形」といったタスクは、必ずしも最上位の巨大モデルを動かす必要はありません。
「日常処理は軽量・ローカルモデルで効率的に処理し、高度な推論が必要な局面でのみ上位モデルを投入する」という多層的な防御設計を持つことが、持続可能なAI運用の鍵となります。
2. あなたの環境に最適な「4つの運用ルート」
読者の皆様のマシンスペック、利用中のプラン、予算に応じて最適なアプローチは異なります。まずはご自身に合ったルートを確認しましょう。
| 運用ルート | こんな方におすすめ | 使用する技術・モデル | コストの目安 | 主な特徴・注意点 |
|---|---|---|---|---|
| ルート1:ローカルLLM完結型 | API費用を抑えたい・機密データを外部送信したくない方 | Ollama(Qwen 2.5 Coder / Llama 3.2 / Gemma 2 等) | API費用0円 | 外部API通信なしで処理可能。PCスペック(特にRAM)に依存。※Web検索等の外部連携機能は別途通信が必要です。 |
| ルート2:定額サブスク防衛型 (★著者の実践環境) |
Google One等の定額枠内で制限停止を防ぎつつ使い倒したい方 | Antigravity + GEMINI.md行動ルール | 月額定額のみ | 追加課金なし、PCスペック不問。ルールによるエージェント誘導が重要。 |
| ルート3:クラウド無料枠・高速型 | 低スペックPCだがAPI費用を抑えて高速処理したい方 | Google AI Studio(Gemini Flash無料枠 / Gemma 2 API) / Groq | 無料枠内(0円〜) | PCへのマシン負荷なし。各サービスが規定する1分/1日あたりの利用制限(Rate Limit)に留意。 |
| ルート4:API従量課金・安全管理型 | 開発用APIキーで運用しつつ予算事故を防ぎたい方 | Gemini Flash-Lite + 予算監視・自動停止設計 | 従量課金(低単価) | 低単価モデルを活用しつつ、予算アラート(Budget Alert)による通知や支出上限設定でコストを管理。 |
3. ローカルLLM&軽量モデルの「スペック・選定の目安」
ローカルLLM(Ollama等)を活用する際は、マシンのハードウェア環境(RAM・GPU)に応じた適切なモデルサイズを選ぶことが快適な動作の前提となります。
主要ローカルモデルの特徴一覧
| モデル名 | 開発元 | モデルサイズ展開 | 特徴・得意領域 |
|---|---|---|---|
| Qwen 2.5 Coder | Alibaba | 0.5B / 1.5B / 3B / 7B / 14B / 32B | オープンソースのコード特化モデル。日本語の文脈理解力にも定評がある。 |
| Llama 3.2 / 3.3 | Meta | 1B / 3B / 8B / 70B | オープンモデルの世界標準。エコシステムが充実しており、軽量な3.2は低負荷用途に適する。 |
| Gemma 2 | 2B / 9B / 27B | Google製オープンモデル。軽量ながら高い推論性能。ローカルとクラウドAPIの双方で利用可能。 | |
| DeepSeek-R1(蒸留版) | DeepSeek | 1.5B / 7B / 8B / 14B / 32B / 70B | 思考プロセス(Chain of Thought)を備え、複雑なロジック検証やバグ特定に向く。 |
| Phi-3.5 / Phi-4 | Microsoft | 3.8B / 14B | 超小型・高知能設計。メモリ制限の厳しい環境でも高い論理推論性能を発揮。 |
PCスペック別・モデル選定の目安
| マシンスペック | 搭載メモリ(RAM) | 選定の目安(量子化4-bitモデル) | 用途・運用の目安 |
|---|---|---|---|
| エントリー環境 一般的なノートPC / M1・M2 Mac(8GB) |
8GB 〜 16GB | qwen2.5-coder:3bllama3.2:3bgemma2:2b |
メモリ圧迫を抑えて動作可能。コード補完やテキスト整形・要約向き。 |
| 標準環境 M系Mac(16GB〜24GB)/ ゲーミングPC |
16GB 〜 32GB | qwen2.5-coder:7bllama3.1:8bgemma2:9b |
コーディング支援や関数作成など、実務でバランス良く活用可能。 |
| ハイエンド環境 Mac Studio / 大容量VRAM搭載PC |
32GB以上 | qwen2.5-coder:14bdeepseek-r1:14b |
複雑な論理推論や大規模リファクタリングをローカルで試行可能。 |
[!TIP]
【補足】GemmaやGeminiの「クラウドAPI無料枠」という選択肢
手元のPCスペックが限られている場合は、ローカル実行にこだわらず、Google AI Studioの無料枠やGroqを利用することで、PCにマシン負荷をかけずにクラウド上で高速な推論を活用できます。
4. 実装編:AntigravityとローカルLLMの連携(公式SDK準拠)
AntigravityとローカルLLM(Ollama等)を連携させる際は、「Antigravity Python SDKを用いた連携」と「Antigravity IDE(エディタ)での利用」の2つのレイヤーがあります。
1. Ollamaの起動とモデル準備
まずはローカルマシンにOllamaをセットアップし、バックグラウンドサーバー(http://localhost:11434)で待機させます。
# 1. Ollamaのインストール(macOSの場合はHomebrew等)
brew install ollama

# 2. モデルのダウンロードと起動
ollama run qwen2.5-coder:7b
2. Antigravity SDKにおける公式接続コード例
Googleの公式 Antigravity Python SDK では、OllamaなどのOpenAI互換ローカルサーバーへ接続するための LocalOpenAIAgentConfig が提供されています。エージェントは非同期コンテキストマネージャーとして安全に呼び出すのが標準的な設計です。
import asyncio
from google.antigravity import Agent, LocalOpenAIAgentConfig

async def main():
    # Ollamaのローカルエンドポイントを指定して軽量設定
    config = LocalOpenAIAgentConfig(
        model="qwen2.5-coder:7b",
        base_url="http://localhost:11434/v1",
    ).lightweight()

    async with Agent(config) as agent:
        response = await agent.chat(
            "この関数のテストコードを作成してください。"
        )
        print(await response.text())

if __name__ == "__main__":
    asyncio.run(main())
※ Antigravity IDE本体からローカルモデルを直接呼び出す場合は、MCP(Model Context Protocol)サーバーを経由してローカルLLMをツールやサブエージェントとして登録するアプローチが活用されます。
[!TIP]
【あわせて読みたい】Antigravityと外部ツールを繋ぐMCP連携の基本
AntigravityとObsidian等のローカル資産を連携させるMCP環境構築については、以下の解説記事で詳しく手順を公開しています。
👉 【完全解説】AntigravityとObsidianを連携して「記憶を自動記録」する環境構築ガイド
5. 【核心】事故を防ぐ「3層防衛アーキテクチャ」の設計
AIエージェントの課金事故や暴走を防ぐためには、「プロンプトに気をつける」だけでは不十分です。「ルール」「システム実装」「人間の承認」という3つの防御層を重ねる設計が不可欠です。
【第1層:行動ルール(GEMINI.md)】 ➔ AIに「無駄遣い・暴走をしない」行動規範を指示
  ▼
【第2層:システム制限】 ➔ 実行回数・タイムアウト・ファイル数・予算アラートで防衛
  ▼
【第3層:人間の承認ゲート】 ➔ 大規模変更・外部送信・課金処理は必ず人間が手動承認
第1層:エージェントの行動ルール(GEMINI.md)
ワークスペース直下に配置するルールファイル(GEMINI.md や AGENTS.md)は、エージェントに対して「無駄な試行錯誤を控え、軽量モデルを意識して動く」よう誘導する行動指針として機能します。
# Antigravity Agent Resource Control Rules (リソース防衛規律)

## 1. モデル利用とタスク配分の指針
- **標準実行:** ファイル検索、差分確認、フォーマット整形、ログ解析などの定型作業は、軽量モデル(Flash-Lite / ローカルLLM)での処理を前提とする。
- **上位モデル昇格の制限:** 高度な推論モデルは、複雑なアーキテクチャ設計や難解なエラーデバッグに限定し、日常作業での安易な呼び出しを控えること。
- **サブエージェント増殖の抑制:** 明示的な指示がない限り、多段のサブエージェント自動生成を行わないこと。

## 2. コンテキスト過熱・暴走防止
- **生データの直接読み込み制限:** 巨大なログやHTMLをそのまま吸い込まず、grepやスクリプトで要点を抽出して読み込むこと。
- **セッション切り替え(息継ぎ)の提案:** 会話履歴が長くなった場合は、中継ぎサマリーを提示し、新しいセッションへの移行を促すこと。
第2層:システム制限(実装による歯止め)
- API利用時: Google Cloudの予算アラート(Budget Alert)を設定し、想定外の支出をメール等で早期検知する(必要に応じて支出上限機能の適用や、自動停止スクリプトを構築)。
- ローカル処理時: コマンド実行時のタイムアウト設定や、1回に編集するファイル数の上限をスクリプト側で制限する。
第3層:人間の承認ゲート
- コードの大規模な書き換え、ファイルの削除、外部APIへの一括送信などは、ルールに書くだけでなく「ツールの自動実行をオフにし、必ず人間がIDE上で承認ボタンを押すまで実行されない設定」を徹底します。
6. 【最も簡単な実践法】この記事をそのままAIエージェントに読ませて壁打ち構築しよう
「設定手順を自分で一つずつ調べるのが面倒」「自分のPCスペックでどのモデルがベストか迷う」という方は、この記事のURL(または本文)をそのままAntigravityやCursor、Claude CodeなどのAIエージェントに読み込ませる方法が最も確実で簡単です。
以下のプロンプトをそのままエージェントに投げてください。
この記事の内容を前提知識として読み込んでください。
私のPC環境(OS、メモリ容量、GPU有無)と現在の利用プラン(Google One定額 / API従量課金 / 完全無料)を診断した上で、最適な「防衛ルート」を提案してください。

その上で、以下のステップを対話しながら一緒に構築してください:
1. 私のマシンに最適なローカルLLM(Ollama等)の選定と起動コマンドの提示
2. 私のワークスペースに最適な「GEMINI.md(エージェント行動規範)」の自動生成
3. 予算超過や予期せぬループを防ぐための注意点とチェックリストの作成
AIエージェント自身があなたのPCスペックを読み取り、最適なモデル選定からルールファイルの配置まで、対話しながら完全エスコートしてくれます。
7. 注意点とトラブルシューティング
- ローカルLLM使用時にPCの負荷が高い場合:
- モデルサイズを「7B」から「3B」や「1.5B」へ下げるか、4-bit量子化モデル(
q4_K_M等)を選択してください。 - 日本語の出力精度を重視したい場合:
- 日本語コーパスの学習割合が高い
Qwen 2.5 CoderやGemma 2の選定を推奨します。 - ルールファイル(GEMINI.md)の過信は禁物:
- ルールはあくまでエージェントへの「行動指示」であり、モデル選択の「絶対的なシステム強制」ではありません。第2層(システム制限)や第3層(人間承認)と必ずセットで運用してください。
8. よくある質問(FAQ)
Q1. Apple Silicon Mac(M1/M2/M3)の8GBメモリでもローカルLLMは動きますか?
A. 3B前後の超軽量モデルであれば動作の目安となります。
統合メモリ(Unified Memory)の恩恵により、qwen2.5-coder:3b や llama3.2:3b などの軽量モデルであれば日常的なテキスト整形やコード補完に活用できます。
Q2. 完全オフライン環境でもエージェント開発は可能ですか?
A. モデル推論自体はオフラインで完結します。
モデルファイルを事前にダウンロードしておけば、インターネット接続がない環境でもローカル推論が可能です。ただし、エージェントがWeb検索や外部API連携、オンライン認証を伴う処理を行う場合は別途通信が必要となります。
Q3. 軽量モデルだけで複雑なシステム開発もすべて完結できますか?
A. 難解な設計や大規模リファクタリングには上位の推論モデルとの併用を推奨します。
軽量モデルは定型作業や小規模な修正に強みがありますが、高度な論理推論においては公式の上位推論モデルが優位です。「日常作業は軽量モデル、難問は上位モデル」というハイブリッド運用が実務上最も安定します。
9. まとめ:賢い使い分けで持続可能なAI開発環境を整えよう
AIエージェントの運用で最も重要なのは、「すべてを1つの巨大モデルに丸投げすること」ではなく、「タスクの難易度に応じたモデルの使い分け」と「3層の防衛設計」を持つことです。
- 機密保護・API費用抑制 ➔
Ollama + Qwen 2.5 Coder(ローカル運用) - 定額枠の有効活用 ➔
Antigravity + GEMINI.md行動ルール - 安全管理の徹底 ➔
行動ルール + システム制限 + 人間承認の3層防御 - 迷ったら ➔
この記事をAIに読ませて1発セットアップ
ご自身の開発環境や予算に合わせた防衛体制を整え、予期せぬコストや制限に悩まされない快適なAI開発ライフを築いてください。