[!NOTE]
この記事の要約
- 結論: ObsidianとローカルLLM(Ollama等)を組み合わせることで、外部APIへのデータ送信を抑えながらAPI従量課金なしで、ノートの自動整理・Wikiリンク候補抽出・データベース連携を行う仕組みを構築できます。
- 解決する悩み: 「書き溜めたノートが散らかって死蔵している」「クラウドAIに未公開メモを送信するのが不安」「毎回チャット画面を開いて指示を出すのが面倒」
- 3つのポイント:
- Obsidian×ローカルLLMでできること(分類、要約、Wikiリンク抽出、ローカルRAGとの違い)
- Ollamaを活用した基本セットアップとモデル選定の考え方
- 「人間による承認」を挟んで元ノートを守る、自作Python+SQLite連携の実践アーキテクチャ
Obsidianで日々の思考やアイデアをメモしていると、
「書き溜めたノートが散らかってしまい、どこに何があるか分からなくなる」
「タグ付けやWikiリンクを手動で整理するのは面倒で続かない」
という悩みに直面することがあります。
ChatGPTやClaudeなどのクラウドAIを使えばノートの整理や要約は可能ですが、**「個人の日記や未公開のビジネスアイデアを外部APIへ送信することへの懸念」や「処理するノート数が増えるほど膨らむAPI費用」**がネックになりがちです。
そこで有力な選択肢となるのが、**「Obsidian × ローカルLLM(Ollamaなど)」**の組み合わせです。
自分のPC環境内でオープンなAIモデルを動作させることで、外部APIへのデータ送信を抑えながら、バックグラウンドでノートの分類・整理やリンク抽出を支援させる仕組みを作ることができます。
この記事では、まずObsidianでローカルLLMを使うと何ができるのか・基本構成・RAGとの違いを整理した上で、私が実際に構築・運用している**「人間による承認を前提とした、ローカルLLMによる自動整理とSQLite連携システム」の実録構成**を詳しく解説します。
1. ObsidianでローカルLLMを使うと何ができるのか?
ObsidianとローカルLLMを組み合わせることで、単なる「AIとの対話(チャット)」にとどまらず、ナレッジベースのメンテナンスを効率化する様々な処理が可能になります。
【Obsidian】ノート作成
   ↓(ローカル環境で処理)
【ローカルLLM】分類 / 要約 / リンク抽出 / 検査
   ↓
【Obsidian / ローカルDB(SQLite)】整理完了・データ連携
代表的な活用パターンは以下の通りです。
メモの自動分類・タグ付け
00_Inbox などの未整理フォルダに書き留めたメモの内容をローカルLLMが解析し、適切なカテゴリフォルダへの振り分けや、関連するハッシュタグの候補生成を行います。
関連ノートのWikiリンク候補の自動抽出
新しく書いたノートと過去のノート群を比較し、「この記事と関連性の高い過去ノート」を検出して [[関連ノート名]] のWikiリンク候補をリストアップします。
ノートの要約・論理チェック(Lint)
長文のメモから要点(サマリー)を抽出したり、記述内容の矛盾やフォーマット崩れを検知して校正・整形を支援します。
Vault全体のローカル検索・ローカルRAG(検索拡張生成)
近年注目を集めているのが、Obsidianの保管庫(Vault)内のノートをインデックス化し、ローカルLLMと組み合わせて「自分の過去メモだけを情報源として質問に答えさせる」ローカルRAG(Retrieval-Augmented Generation)環境の構築です。
外部データベース(SQLite等)との連携
整理されたノートの中から「外部へ発信する価値のある知見」をローカルLLMが抽出し、SQLiteなどのローカルデータベースへ書き込んでSNS予約や別ツールへ渡すパイプラインを組むことができます。
2. 「ローカルLLM」と「ローカルRAG」の違い
ObsidianとAIの連携を調べる際によく混同されるのが、「ローカルLLM」 と 「ローカルRAG」 の違いです。
■ ローカルLLM(単体):
[ユーザーの入力] ───▶ [ ローカルLLM ] ───▶ [ 回答・分類・要約 ]
※モデル自身の知識や与えられたプロンプトのみで処理する

■ ローカルRAG(LLM + 検索システム):
[ユーザーの質問] ───▶ [ Vault内を検索・抽出 ]
                             │ (関連ノートを取得)
                             ▼
[ ローカルLLM ] ───▶ [ 過去メモに基づいた回答 ]- ローカルLLM: テキストの生成・分類・要約を行う「推論エンジン」そのものをローカル環境で動かす仕組みです。
- ローカルRAG: ノートなどの外部情報を検索(Retriever)し、見つかった関連情報をローカルLLMへの入力に組み込むことで、Vault内の情報を参照した回答を生成する「応用システム」です。
つまり、**RAGそのものがLLMなのではなく、ローカルLLMにVault検索機能を組み合わせた構成が「ローカルRAG」**です。
本記事で紹介する自動整理システムは、RAGではなく「未整理ノートをローカルLLMが直接読み取って分類・リンク抽出を行うパイプライン」ですが、整理された綺麗なVaultを作っておくことは、将来的に高精度なローカルRAGを運用する上でも非常に重要な基礎となります。
3. ObsidianとローカルLLMを組み合わせるメリット
クラウド上のAPI(OpenAIやAnthropicなど)ではなく、ローカルLLMを採用する理由は大きく3つあります。
| 比較項目 | クラウドAI(API利用) | ローカルLLM(Ollama等) |
|---|---|---|
| API従量課金 | 処理量に応じて費用が発生 | 通常は発生しない |
| データプライバシー | 外部サーバーへデータ送信 | 外部APIへのデータ送信を抑えられる |
| オフライン動作 | 不可(常時ネット接続が必要) | モデル推論自体はネット接続なしで実行可能 |
| 処理速度・回答精度 | 非常に高い(超大規模モデル) | PCスペックに依存(軽量モデル中心) |
① クラウドAPI料金(従量課金)が発生しない
クラウドAPIを利用してノートの自動巡回を行うと、ノート数や実行頻度に比例してトークン費用が発生します。ローカルLLMによる処理では、PCのハードウェアリソースを消費するものの、クラウドAPIの従量課金は発生しません。
② 機密情報・個人の未公開メモの外部送信を抑えられる
ローカルLLMで処理する範囲では、ノート本文を外部サーバーへ送信せずにローカル環境内で完結して処理できます。ビジネスの機密メモや個人のプライベートな日記であっても、クラウドAIへ送信する場合と比べて外部へのデータ流出リスクを大幅に低減できます。
③ モデル推論自体はオフラインで実行可能
インターネット接続が不安定な場所や完全なオフライン環境でも、PC単体でテキスト解析や要約タスクを実行できます。
4. ObsidianでローカルLLMを動かす基本構成(Ollama)
ObsidianとローカルLLMを連携させる際、最も標準的で扱いやすいのが Ollama(オラマ) をバックエンドに使う構成です。
[ Obsidian Vault ]
       │
       ▼(Pythonスクリプト または コミュニティプラグイン)
[ Ollama (ローカルAPI: localhost:11434) ]
       │
       ▼
[ ローカルLLMモデル ]
なぜOllamaが選ばれるのか
- ワンコマンドで導入可能: macOS、Windows、Linuxに対応し、誰でも手軽にセットアップできます。
- ローカルAPIサーバー機能: 起動するとローカル(
http://localhost:11434)でAPIサーバーが立ち上がるため、PythonスクリプトやObsidianプラグインから標準的なHTTPリクエストで呼び出せます。
モデル選定の考え方(実録環境と最新の選択肢)
ローカルLLMの世界は進化が非常に速いため、「実際に構築した検証環境」と「現在の選択肢」を分けて考えることが大切です。
- 実録環境(本システム構築時の実績):
- 実際のシステム構築・運用検証には
qwen2.5:3bを使用しました。日本語の処理能力が高く、JSON出力や分類などの指示追従性が極めて安定していたためです。
- 実際のシステム構築・運用検証には
- 現在の選択肢:
- 3B〜8Bクラスのモデル(Qwen系、Gemma系、Llama系など)は日々新しいバージョンが登場しています。ご自身のPCスペック(Apple Silicon Macのメモリ容量やGPU環境)に合わせて、Ollama公式ライブラリから最適なモデルを選択してください。
動作確認:ターミナルからOllamaをテストする
Ollamaをインストール後、ターミナルで以下のコマンドを実行するだけで、AIを「テキストの入出力フィルター」として動作させる感覚を体験できます。
# テキストをパイプで渡し、チャット画面を開かずに抽出結果だけを取得する
echo "ローカルLLMを活用することで、ノート本文を外部へ送信せずに安全な自動整理が可能になる。" | ollama run qwen2.5:3b "入力文から重要キーワードを3つ抽出し、カンマ区切りで出力してください。解説は不要です。"
5. 【実録】Obsidian×ローカルLLMで構築した「自律型自動整理システム」
ここからは、私が実際に日々の作業環境で構築・運用している自律型ナレッジ自動整理システムの実例を紹介します。
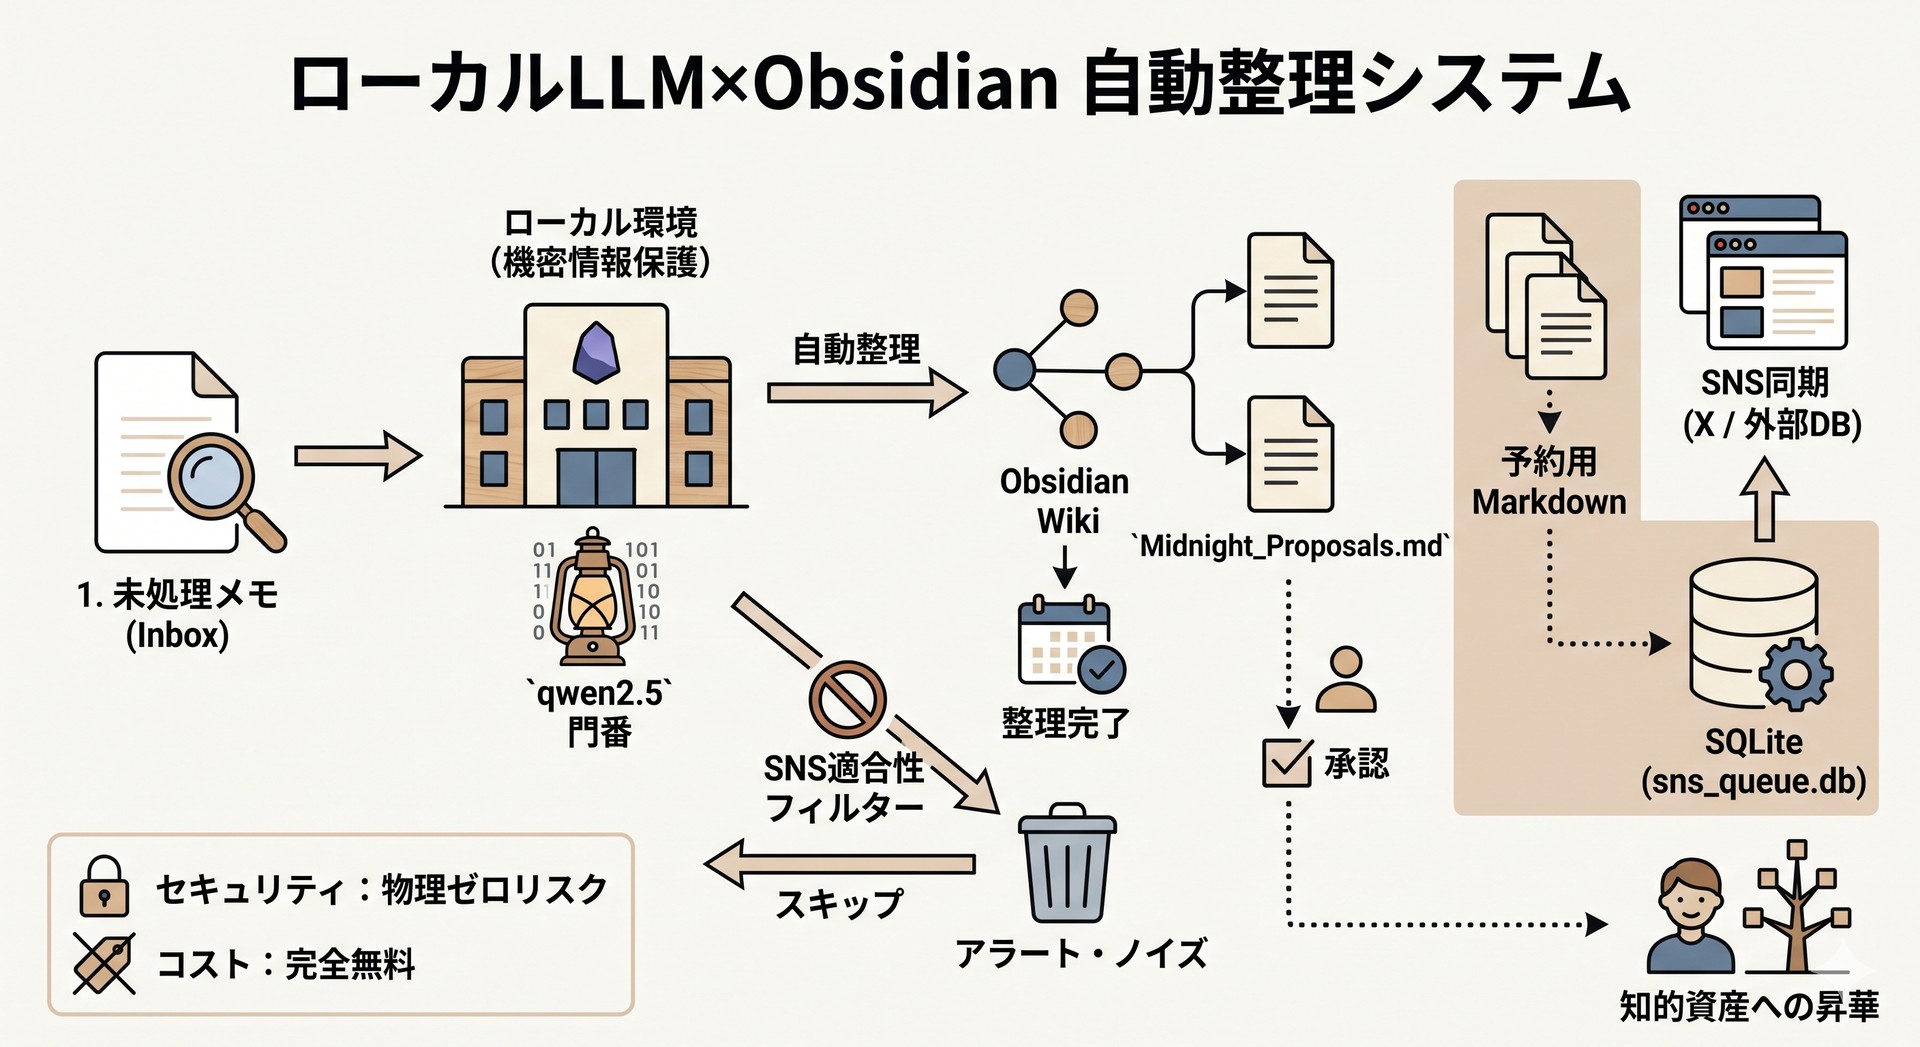
このシステムは、単に「Obsidian内でAIに質問する」のではなく、**「人間がメモを書くだけで、背後に常駐するローカルAIが自動で整理・選別し、人間の承認を経てデータベースまで同期する」**というバックグラウンドインフラです。
システム全体の構成図
【1. 入力】
Obsidian (00_Inbox) に日々の思考・テックメモを保存
   │
   ▼ (定期巡回スクリプト: Python)
【2. ローカル解析 & 適合性選別】
Ollama (qwen2.5:3b)
  ├─ ① Wikiリンク候補の抽出・論理チェック
  └─ ② 発信価値の判定(日記は除外、有益な知見のみ抽出)
   │
   ▼
【3. 安全なワンクッション】
提案書(Midnight_Proposals.md)を出力
人間が朝、内容を確認して [x] をチェック
   │
   ▼ (マージスクリプト: Python)
【4. 整理完了 & DB同期】
  ├─ Obsidian元ノートへWikiリンクを安全にマージ
  └─ SQLite (sns_queue.db) へ投稿ドラフトを書き込み
① Inbox巡回と適合性フィルター(ノイズの遮断)
AI自動化ツールを導入した際によくある失敗が、「個人的な日記や単なる愚痴からまでAIが勝手にSNS投稿案を作ってしまい、提案リストがゴミだらけになる」というアラート・ノイズです。
そこで本システムでは、ローカルLLMに**「適合性フィルター」**の役割を持たせています。
未整理メモを検知
   ↓
「この記事は外部に共有すべき技術的知見や哲学を含んでいるか?」をローカルLLMが判定
   ├─ [該当なし(日記等)] ➔ ノートのWikiリンク接続のみ行い、SNS提案はスキップ
   └─ [該当あり(有益知見)] ➔ X用140文字ドラフトを生成し、提案書へ記載
これにより、人間が確認すべき提案書には「本当に価値のあるアイデア」だけが並ぶようになります。
② ワンクッションの安全性(提案書方式で直接上書きしない)
AIがObsidianの元ノートを勝手に直接書き換えてしまうと、誤判定やハルシネーションによって大切なメモが破損する危険があります。
そのため、本システムでは**「直接書き換えないワンクッション設計」**を採用しています。
- ローカルAIは夜間などにナレッジを巡回し、提案書ファイル(
Midnight_Proposals.md)に以下のようなチェックボックス形式で追記します。 - 人間は朝、その内容を見て採用したい項目だけに
[x]を入れます。
## 2026-08-22 の整理提案

- [x] **[[Python自動化]] へのリンク追加**
  - 対象ノート: `Obsidian連携スクリプト.md`
  - 理由: 本文内でPython標準ライブラリによる処理を扱っているため。

- [ ] **SNS投稿ドラフト(X用)**
  - 提案文: 「ObsidianとローカルLLMを組み合わせると、APIコストを気にせずノート整理を自動化できます...」
③ チェックボックス一つでSQLiteデータベースへ同期
提案書で [x] が付いた項目のみを検知し、Pythonスクリプト(apply_proposals.py および sync_to_db.py)が実行されます。
- 元ノートへのリンク反映: 承認されたWikiリンクが安全に元ノートへ挿入されます。
- SQLiteへの書き込み: 承認されたSNSドラフトは、ローカルデータベース(SQLite
sns_queue.db)のキューテーブルへ直接書き込まれます。
これにより、人間は**「メモを書く ➔ 朝、提案書にチェックを入れる」**という最小のアクションだけで、人間の承認を挟みながら、ノートの整理からデータベースへのデータ登録までをスムーズに連携させることができます。
6. 実際に運用して分かったメリットと注意点
メリット:チャットを開かずに「背後のインフラ」として機能する
最大の実感は、**「AIと対話する時間そのものが減った」**ことです。
毎回チャット画面を開いてプロンプトを入力するのではなく、AIが背後で静かに動き、人間は承認ボタン(チェックボックス)を押すだけ。この「非同期なインフラ化」こそが、知的生産を妨げない理想の形です。
注意点:ローカル実行時のリソースと精度のバランス
- 過信は禁物: 軽量モデル(3B〜8B)は分類や要約などの定型処理には非常に強いですが、高度な長文執筆や複雑な推論ではクラウドのフロンティアモデル(GeminiやClaudeなど)に劣ります。
- 役割の分担: 「日々の大量の巡回・分類・抽出はローカルLLM」「高度な構成検討や最終仕上げはクラウドAPI」というハイブリッドな使い分けが最も実用的です。
7. よくある質問(FAQ)
Q: GPUのない普通のノートPCでも動きますか?
動きます。OllamaはCPU実行やApple Silicon(Mシリーズ)のユニファイドメモリに最適化されており、3B〜7Bクラスの軽量モデルであれば専用GPUのない一般的なPCでも実用的なスピードで動作します。
Q: クラウドAI(ChatGPT/Claude)とローカルLLMはどう使い分けるべき?
- ローカルLLM: 大量のノート巡回、カテゴリ分類、キーワード抽出、機密メモの処理など「プライバシー重視・高頻度な定型タスク」
- クラウドAI: 複雑なロジック設計、長文記事の執筆、深い推論が必要なリサーチなど「知能の高さが求められるタスク」
Q: Obsidianのデータが勝手に書き換わるリスクはありませんか?
直接上書きするプラグインやスクリプトを使用するとリスクがあります。本記事で紹介したように「提案書(Markdown)を別ファイルとして出力し、人間が承認したものだけをマージする」というワンクッション設計を挟むことで、データを直接上書きするリスクを低減できます。
Q: RAG(Vault全体の検索)とは何が違うのですか?
本記事のシステムは「未整理ノートを検知して分類・リンク付けを行う自動パイプライン」です。一方、RAGは「蓄積されたノート全体を検索し、質問に対して回答を生成する仕組み」です。両者を組み合わせることで、自動整理された綺麗なVaultに対して高精度なローカルRAGを行うことが可能になります。
8. まとめ
ObsidianでローカルLLMを活用する本質は、単に「ローカルでAIとチャットすること」ではありません。
Obsidian(思考のアウトプット)
   ↓
ローカルLLM(背後で静かに整理・選別)
   ↓
人間によるワンクリック承認
   ↓
知的資産の蓄積・外部連携
このように、**「AIを対話相手から、自分のナレッジベースを守り育てる静かなインフラへ移行させること」**にあります。
まずはご自身のPCにOllamaをインストールし、軽量なモデルでノートを要約してみる「最初の一歩」から始めてみてください。Vaultを単なるメモ置き場ではなく、整理・検索・再利用できる知識基盤として育てていくことができます。
📖 あわせて読みたい珈琲・抽出の関連記事
【あわせて読みたい】スマトラ式(ウェットハル)が生み出す重厚なコクと大地の香り

【あわせて読みたい】日本の四季に合わせたドリップレシピと旬のペアリング